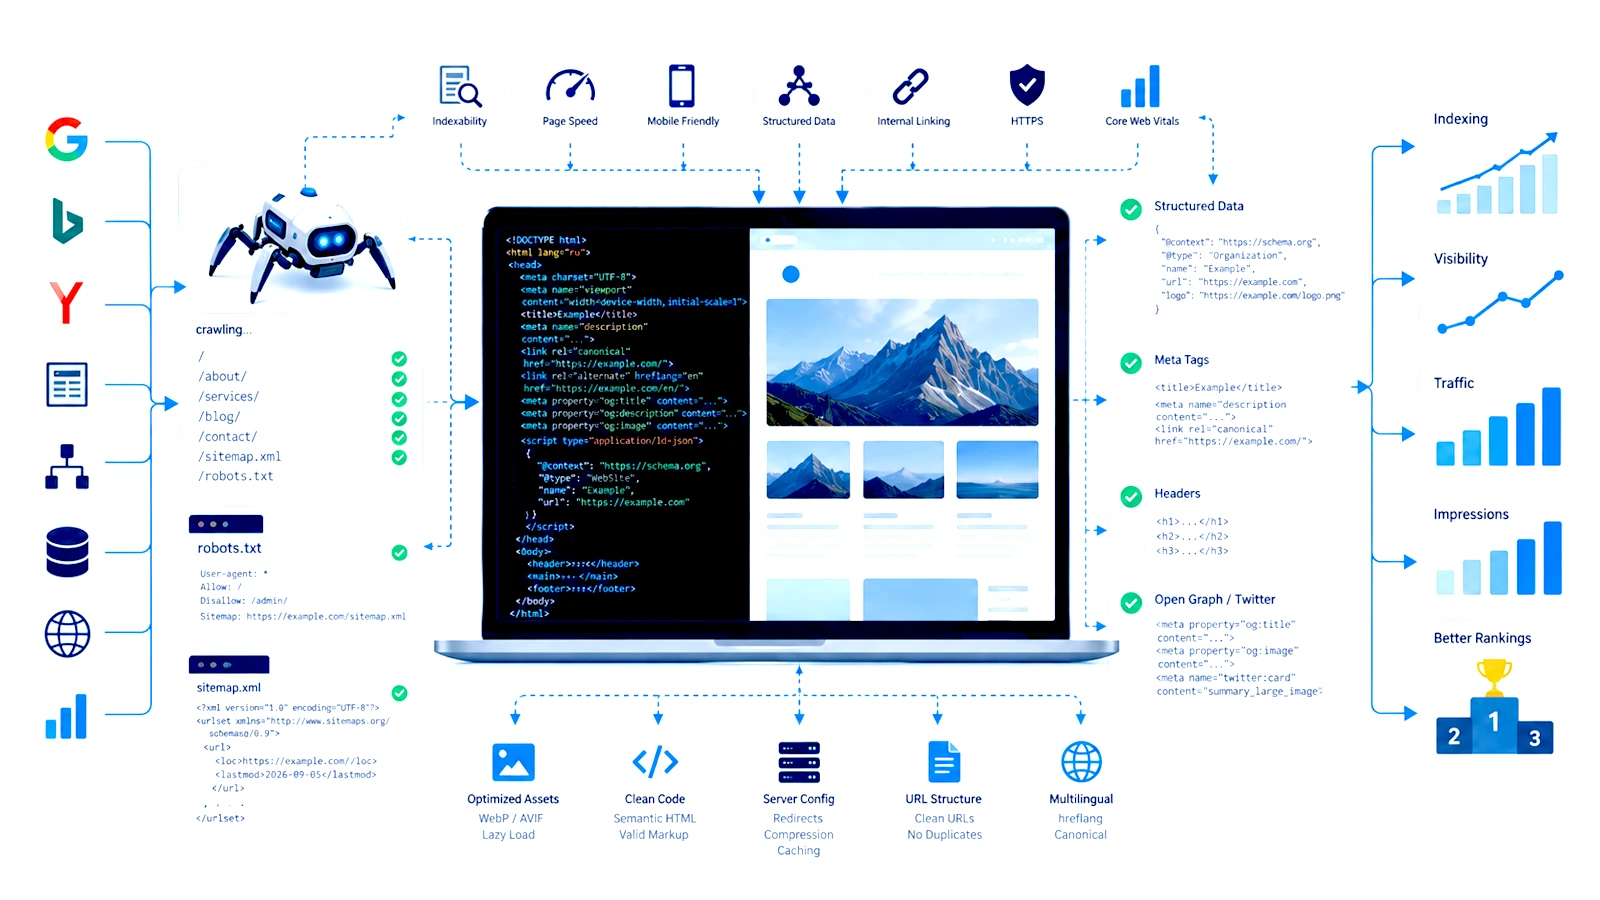
Рынок разработки сайтов давно привык к удобной схеме. Сначала заказчику продают дизайн, верстку и запуск. Потом приходит SEO-специалист, запускает сканер и обнаруживает, что сайт технически не готов к нормальной работе с поисковыми системами. Дубли URL, неправильные ответы сервера, хаотичные редиректы, отсутствующие canonical, тяжелые изображения, закрытые страницы, битые ссылки, ручной Sitemap, метаданные, которые невозможно изменить без программиста.
После этого заказчик получает еще один счет. Теперь уже за «техническую SEO-оптимизацию».
Вопрос здесь предельно простой: если сайт только что разработали, почему его сначала нужно ремонтировать, чтобы начать продвигать?
Если первый SEO-аудит нового сайта в основном состоит из исправления ошибок backend, frontend и архитектуры, перед вами не новая SEO-стратегия. Перед вами счет за технический долг, который уже один раз был оплачен при разработке.
Я называю этот подход техническим SEO (или SEO-ready). Не потому, что это новый модный термин, а потому, что значительная часть технической готовности сайта действительно создается инженером: в архитектуре, маршрутизации, шаблонах, моделях данных, серверной конфигурации и системе управления контентом.
Техническое SEO не должно появляться на сайте как аварийная бригада после релиза. Оно должно быть частью требований к самому продукту.
SEO начинается не с ключевых слов. Оно начинается с того, может ли поисковик нормально работать с сайтом
Можно написать прекрасный текст. Можно собрать семантику. Можно заказать десятки статей. Можно месяцами анализировать конкурентов. Все это имеет смысл только тогда, когда поисковая система способна нормально обнаружить страницу, получить ее содержимое, понять ее адрес и отличить актуальный документ от дублей и технического мусора.
Для этого сайт должен решать совершенно обычные задачи:
- Возвращать корректные HTTP-ответы;
- Иметь предсказуемую структуру URL;
- Правильно обрабатывать удаленные и перемещенные страницы;
- Давать поисковому роботу доступ к нужному содержимому;
- Позволять управлять индексацией;
- Формировать актуальный Sitemap;
- Не плодить бесконтрольные дубли;
- Позволять редактору управлять метаданными;
- Отдавать нормальный HTML, а не технологический мусор;
- Не заставлять пользователя ждать загрузки страницы из-за плохих инженерных решений.
Ни один пункт в этом списке не является эзотерикой поискового продвижения. Это характеристики нормально разработанного веб-приложения.
Поисковый робот не будет разбираться в последствиях плохой разработки. Если сайт сам создает хаос, поисковая система не будет исправлять его за разработчика.
Что инженерное SEO дает бизнесу на практике
Самая большая ошибка в разговоре о техническом SEO — обсуждать его только в терминах тегов, файлов и баллов PageSpeed. Будем честны: вам не нужен canonical сам по себе. Вам не нужен Sitemap как коллекционный XML-файл. Вам нужен сайт, который можно нормально продвигать, расширять и передавать другой команде без капитального ремонта.
Именно здесь техническая подготовка превращается из набора настроек в экономическое преимущество.
SEO-бюджет уходит на развитие вместо бесконечных исправлений недочетов разработки
SEO-специалист стоит денег. И нормальный SEO-специалист действительно должен стоить денег, потому что поисковый спрос, конкуренты, контент, структура посадочных страниц и анализ результатов требуют постоянной работы.
Но оплачивать квалифицированного специалиста для того, чтобы он месяцами составлял задачи программисту на исправление базовых дефектов свежего сайта, — сомнительная экономика.
На технически подготовленном проекте SEO-команда может сразу заниматься тем, за что ей действительно платят:
- Анализировать поисковый спрос;
- Проектировать посадочные страницы;
- Изучать конкурентов;
- Развивать контент;
- Работать с перелинковкой;
- Анализировать поисковую видимость;
- Искать новые точки роста.
Это и есть нормальное разграничение обязанностей. Разработчик строит исправный инструмент. SEO-специалист использует этот инструмент для продвижения бизнеса.
Новые страницы можно запускать без программиста
Один из лучших тестов качества CMS очень простой: попробуйте создать новую посадочную страницу.
Если для этого нужно написать разработчику, попросить его добавить новый шаблон, вручную прописать title, внести страницу в Sitemap и отдельно настроить canonical — перед вами не гибкая контентная система. Вы будете платить разработчикам за каждую мелочь, которая в нормальном проекте должна быть автоматизированна.
В нормальной архитектуре новая страница должна получать необходимые технические механизмы автоматически или через предусмотренные поля CMS:
- Корректный URL;
- title и description;
- canonical;
- Настройку индексации;
- Включение в Sitemap при необходимости;
- Структурированные данные, если они предусмотрены типом страницы;
- Корректное отображение в навигации и внутренних связях.
Это не отменяет работу SEO-специалиста над содержанием страницы. Это отменяет необходимость платить программисту за техническую возможность эту работу выполнить.
Сайт дешевле развивать
Плохая архитектура редко проявляет настоящую стоимость в день запуска. В день запуска все обычно выглядит нормально: главная открывается, кнопки нажимаются, форма отправляется.
Проблемы начинаются позже. Бизнес запускает новое направление. Меняет структуру услуг. Добавляет языковую версию. Переносит каталог. Создает блог. Удаляет старые материалы. Меняет URL.
И внезапно оказывается, что изменение одной страницы оставляет после себя пять старых адресов, битые ссылки и цепочки редиректов.
Хорошая архитектура экономит деньги не потому, что сайт больше никогда не меняется. Она экономит деньги потому, что сайт можно менять без риска сломать все, что было сделано раньше.
Проект меньше зависит от конкретного подрядчика
Иногда зависимость клиента от студии или фрилансера маскируется под «техническую поддержку». Любое изменение требует обращения к тому же человеку, потому что только он понимает, как устроена система, которую он вам создал.
Это удобная бизнес-модель для исполнителя. Для владельца сайта — не всегда.
Нормально разработанный проект должен оставаться управляемым. Контент редактируется через CMS. SEO-поля доступны. URL имеют понятную логику. Серверная конфигурация документируется. Основные механизмы не спрятаны в десятке случайных плагинов.
Сайт должен быть активом бизнеса, а не заложником человека, который когда-то его собрал.
Корректные HTTP-ответы: сервер должен говорить правду
Пользователь видит страницу. Поисковая система дополнительно видит ответ сервера.
Если страница существует, сервер обычно возвращает 200. Если документа нет — 404 или в подходящем случае 410. Если адрес был навсегда перенесен — используется постоянный редирект, чаще всего 301.
Это базовая логика HTTP.
Но на практике до сих пор встречается другое. Пользователь открывает несуществующий URL, видит красивую страницу «Ничего не найдено», а сервер уверенно сообщает поисковику: 200 OK. То есть говорит: «Все нормально, документ существует». Картинка с числом 404 не превращает ответ 200 в настоящий 404.
Дизайн ошибки не исправляет ошибку протокола.
Google отдельно документирует обработку HTTP-кодов при crawling и indexing. Поисковая система принимает решение о дальнейшей обработке URL в том числе на основании ответа сервера.
URL: одна страница не должна жить под десятком адресов
Структура URL — еще одно место, где плохая разработка потом продается как SEO-проблема.
Одна и та же страница не должна бесконтрольно существовать по множеству адресов только потому, что CMS умеет их генерировать. Источниками дублей могут быть:
- GET-параметры;
- Старые URL после изменения структуры;
- Неправильная маршрутизация;
- Несколько путей к одной сущности;
- Фильтры и сортировки;
- Технические адреса CMS;
- Ошибки при миграции сайта;
- Различия со слешем и без него при неправильной конфигурации.
Разработчик не определяет всю SEO-стратегию канонизации сложного интернет-магазина. Но разработчик обязан построить систему, в которой этой стратегией вообще можно управлять.
Canonical не лечит хаос. Он помогает его не создавать
Canonical сообщает поисковой системе, какой URL владелец сайта считает основной версией документа, когда одинаковое или очень похожее содержимое доступно по нескольким адресам.
Но canonical не является магической командой.
Google прямо рассматривает canonical как один из сигналов при выборе канонической страницы. Если сам сайт одновременно отправляет противоречивые сигналы — ставит один canonical, ссылается внутри на другой URL, включает третий адрес в Sitemap и редиректит пользователя на четвертый — не стоит удивляться, что поисковая система принимает собственное решение.
Canonical не должен исправлять архитектуру. Он должен быть частью архитектуры.
Sitemap должен быть отражением сайта, а не забытым XML-файлом
Sitemap нужен для того, чтобы сообщать поисковой системе об актуальных URL сайта.
Google прямо пишет, что Sitemap является подсказкой, а не гарантией обхода или индексации. Яндекс также отдельно указывает, что наличие URL в Sitemap не гарантирует его появления в поисковой выдаче.
Это нормально. Поисковая система сама решает, что сканировать и индексировать.
Но из этого не следует, что Sitemap бесполезен. Из этого следует только одно: не нужно продавать XML как волшебную кнопку попадания в Google.
В современном сайте Sitemap должен формироваться из реальных данных проекта. Опубликовали новую индексируемую страницу — она появилась в карте. Сняли материал с публикации — система перестала выдавать его как актуальный.
Если контент сайта меняется через CMS, а Sitemap обновляется человеком вручную, автоматизация закончилась слишком рано.
robots.txt: двадцать строк запретов не превращают плохую архитектуру в хорошую
Robots.txt нужен для управления crawling — обходом URL поисковыми роботами.
Но его любят использовать как универсальный пластырь. CMS создала тысячи ненужных адресов? Запретим. Фильтры породили бесконечные комбинации? Запретим. Техническая архитектура расползлась? Напишем еще двадцать Disallow.
Иногда запрет действительно необходим. Но файл robots.txt не должен быть свалкой, куда разработчик заметает последствия собственной архитектуры.
И здесь есть принципиальный момент: запрет обхода и удаление URL из поискового индекса — не одно и то же.
Yandex Webmaster прямо предупреждает, что страницы, запрещенные через robots.txt, все равно могут участвовать в поиске. Для удаления страницы из поиска Яндекс рекомендует использовать noindex в HTML или соответствующий HTTP-заголовок, при этом робот должен иметь возможность получить страницу и увидеть это указание.
Robots.txt определяет, какие страницы поисковый робот может обходить, но сам по себе не гарантирует удаление URL из поисковой выдачи.
SEO-поля должны редактироваться без программиста
Невозможность изменить title без разработчика — не защита системы. Это плохая CMS.
Title, description, canonical, параметры индексирования и другие предусмотренные проектом SEO-настройки должны быть частью модели контента.
Для типовых страниц система может иметь разумные значения по умолчанию. Для важных коммерческих страниц редактор должен иметь возможность переопределить их вручную.
Иначе возникает абсурдная ситуация:
- SEO-специалист замечает проблему в title;
- Создает задачу разработчику;
- Разработчик открывает шаблон;
- Меняет одну строку;
- Делает commit;
- Запускается deployment;
- Клиент оплачивает работу нескольких людей ради изменения текста.
Это не техническая сложность. Это плохо спроектированный процесс.
PageSpeed 100 — хороший скриншот. Но инженерная производительность шире одной цифры
На другом конце рынка существует культ зеленых кружков PageSpeed. Там тоже хватает магии.
Иногда клиенту продают почти религиозную идею: доведем Lighthouse до 100 — и Google откроет ворота в поисковый топ.
Не откроет.
Google использует Core Web Vitals как часть сигналов, связанных с качеством взаимодействия со страницей. Сейчас к основным Core Web Vitals относятся Largest Contentful Paint, Interaction to Next Paint и Cumulative Layout Shift.
При этом сам Google прямо указывает, что хорошие показатели Core Web Vitals не гарантируют высокий рейтинг страницы в результатах поиска.
Это не делает скорость бесполезной. Наоборот. Это возвращает разговор из маркетинга в инженерию.
Быстрый сайт не превращает бесполезную страницу в полезную. Но плохая разработка способна сделать медленной даже хорошую страницу.
Производительность нужно обеспечивать не ради скриншота из теста, а ради нормальной работы продукта.
На нее влияют:
- Размер изображений;
- Форматы изображений;
- Объем JavaScript;
- Лишние CSS;
- Рендеринг страницы;
- Шрифты;
- Кэширование;
- Запросы к базе данных;
- Серверная архитектура;
- CDN при необходимости;
- Аналитика;
- Рекламные скрипты;
- Сторонние виджеты.
CMS и фреймворк сами по себе ничего не гарантируют
WordPress не является автоматически медленным. Django не является автоматически быстрым. Wagtail не выдает инженерное качество вместе с командой установки.
Можно собрать быстрый WordPress. Можно написать чудовищно медленное Django-приложение. Можно превратить любую CMS в кладбище плагинов и JavaScript.
Название технологии не является показателем качества. Архитектура и реализация являются.
Именно поэтому фраза «мы делаем на современной технологии» сама по себе ничего не стоит. Вопрос не в том, что установлено. Вопрос в том, что происходит после запроса пользователя к серверу и сколько лишней работы выполняет система, прежде чем показать страницу.
Машина должна заниматься рутиной, человек — смыслом
Контент-менеджер не обязан знать ImageMagick, вручную считать размеры и перед каждой публикацией конвертировать изображения.
Большую часть технической обработки можно автоматизировать.
- Ограничивать максимальное разрешение;
- Создавать необходимые размеры;
- Сжимать изображения;
- Создавать WebP или AVIF;
- Формировать responsive-варианты;
- Использовать lazy loading там, где это действительно оправдано.
Но alt нельзя бездумно превращать в очередное автоматическое SEO-поле.
Альтернативный текст зависит от смысла изображения в конкретном контексте. Если система берет имя IMG_9384.jpg и превращает его в якобы оптимизированный alt, она не занимается SEO. Она автоматически производит мусор.
Нормальная CMS должна дать редактору возможность задать содержательный alt, а при необходимости — сделать поле обязательным.
Семантический HTML: страница должна быть документом, а не кучей div
Современный frontend позволяет нарисовать почти что угодно. Именно поэтому плохой HTML может прекрасно выглядеть.
Пользователь увидит заголовок. Но в коде он может оказаться стилизованным div. Пользователь увидит кнопку. Внутри может оказаться элемент, который не имеет нормального поведения ссылки или кнопки. Визуально страница существует. Семантически — это набор контейнеров.
Хорошая CMS и хорошие шаблоны задают структуру документа заранее.
- Заголовок остается заголовком;
- Навигация остается навигацией;
- Список остается списком;
- Таблица используется для табличных данных;
- Ссылка используется для перехода;
- Кнопка выполняет действие;
- Основное содержимое можно определить как основное содержимое.
Это важно не только для SEO. Это базовое качество веб-документа и доступности.
Заголовки H1–H6 должны отражать структуру текста
Заголовки нужны не для того, чтобы вставить в каждый еще один поисковый ключ. Их первичная функция гораздо проще: описывать структуру документа.
H1 обозначает основной заголовок страницы. H2 разделяют крупные смысловые части. H3 детализируют их.
Если редактор выбирает H2 только потому, что браузер показывает его шрифтом нужного размера, значит в CMS перепутаны содержание и оформление.
Structured Data: нормальная разметка вместо шаманства со сниппетами
Structured Data позволяет описывать содержимое страницы в машиночитаемой форме. Для Google одним из рекомендуемых форматов является JSON-LD.
С помощью структурированных данных можно описывать поддерживаемые поисковой системой сущности: организацию, статью, хлебные крошки, товар и другие типы контента.
Это полезный инструмент.
Но здесь начинается любимая территория инфомаркетинга: «Добавим Schema.org — получите огромный красивый сниппет и больше кликов».
Такой гарантии нет.
Google прямо указывает в правилах structured data, что корректная разметка не гарантирует отображение расширенного результата.
Structured Data помогает машине понять страницу. Она не дает разработчику права управлять дизайном поисковой выдачи.
Поэтому микроразметка должна внедряться там, где она соответствует реальному содержимому страницы, а не как коллекция всех типов Schema.org, которые удалось найти в интернете.
Техническое SEO должно защищать сайт от обычной эксплуатации
Сайт после запуска попадает в реальный бизнес. А реальный бизнес не обращается с ним как разработчик во время тестирования.
Маркетолог загрузит фотографию размером 7000 пикселей. Редактор поменяет slug. Руководитель попросит удалить старую услугу. SEO-специалист создаст двадцать новых посадочных страниц. Аналитик установит еще один счетчик. Через год появится второй язык.
Хорошая архитектура должна учитывать, что все это произойдет.
Поэтому инженерное SEO — это еще и система защиты от типичных ошибок эксплуатации:
- Автоматическая обработка изображений;
- Контроль допустимых URL;
- Редиректы после изменения адресов;
- Обязательные поля там, где без них нарушается структура;
- Разумные значения по умолчанию;
- Автоматическая генерация Sitemap;
- Предсказуемые шаблоны;
- Контроль публикации и индексации.
Хорошая система не предполагает, что каждый редактор обязан быть SEO-специалистом и backend-разработчиком. Она не дает обычной ошибке пользователя превратиться в техническую аварию.
Кто и за что отвечает: разработка против настоящего SEO
Здесь проходит граница, которую особенно не любят многие агентства и фрилансеры.
Разработчик не обязан гарантировать позиции. SEO-специалист не обязан исправлять архитектуру приложения своими руками. Маркетолог не обязан понимать конфигурацию Nginx.
Но каждый обязан нормально выполнить свою часть работы.
| Работа | Инженерная часть сайта | SEO-работа после запуска | Кто отвечает |
|---|---|---|---|
| Корректные HTTP-ответы | Да | Нет | Разработчик |
| Механизм 301-редиректов | Да | Частично | Разработчик создает механизм, конкретную карту миграции можно проектировать совместно |
| Управление canonical | Да | Частично | Разработчик создает механизм, сложную стратегию определяет SEO |
| Автоматический XML Sitemap | Да | Частично | Разработчик |
| Рабочий robots.txt | Да | Частично | Совместная зона на сложных проектах |
| Управление index / noindex | Да | Частично | Механизм создает разработчик, правила определяются задачей |
| Возможность редактировать title и description | Да | Нет | Разработчик |
| Написание title и description | Нет | Да | SEO / редактор |
| Семантический HTML | Да | Нет | Разработчик |
| Техническая структура H1–H6 | Да | Частично | Разработчик задает шаблон, редактор формирует содержание |
| Structured Data / Schema.org | Да | Частично | Разработчик реализует, набор сущностей зависит от проекта |
| Автоматическая оптимизация изображений | Да | Нет | Разработчик |
| Механизм управления alt | Да | Нет | Разработчик |
| Содержательный alt конкретного изображения | Нет | Частично | Редактор / контент-команда |
| Исходная производительность сайта | Да | Частично | Разработчик |
| Адаптивность | Да | Нет | Разработчик |
| HTTPS | Да | Нет | Разработчик / DevOps |
| Система внутренней перелинковки | Да | Частично | Разработчик создает механизм, SEO определяет смысловые связи |
| Исследование поискового спроса | Нет | Да | SEO |
| Семантическое ядро | Нет | Да | SEO |
| Конкурентный анализ поисковой выдачи | Нет | Да | SEO / маркетинг |
| Проектирование новых посадочных страниц | Частично | Да | SEO определяет необходимость, разработчик дает техническую возможность |
| Создание контента | Нет | Да | Редактор / эксперт / SEO |
| Анализ Google Search Console и Яндекс Вебмастера | Нет | Да | SEO |
| Мониторинг поисковой видимости | Нет | Да | SEO |
| Реакция на изменения поисковых систем | Нет | Да | SEO |
Где начинаются фрилансерские чудеса
Техническое SEO особенно удобно продавать тем клиентам, которые не могут проверить результат самостоятельно.
Им можно показать отчет на пятьдесят страниц, сотни предупреждений из автоматического сканера и огромный список терминов. Чем меньше клиент понимает смысл каждого пункта, тем внушительнее выглядит работа.
Сам по себе аудит нужен. Автоматические инструменты нужны. Проблема начинается тогда, когда отчет становится продуктом вместо решения проблемы.
Найти ошибку сканером и понимать, почему она возникла в архитектуре, — разные уровни квалификации.
Любой инструмент может показать, что страница имеет неправильный canonical. Инженер должен понять, почему система его генерирует, где находится источник ошибки и как исправить механизм так, чтобы проблема не вернулась на следующих тысяче страниц.
Вот здесь и проходит граница между человеком, который умеет запускать SEO-сервис, и человеком, который понимает веб-систему.
Плагин SEO не делает сайт технически оптимизированным
Еще одна классика: установить SEO-плагин и объявить техническое SEO завершенным.
Плагин может добавить поля title, description, canonical, Sitemap и часть structured data. Это полезно. Но он не исправит автоматически:
- Плохую архитектуру URL;
- Медленный backend;
- Неправильную модель данных;
- Лишние запросы к базе;
- Огромный JavaScript bundle;
- Битую внутреннюю перелинковку;
- Ошибочную серверную конфигурацию;
- Неправильные редиректы;
- Непредсказуемую генерацию страниц;
- Архитектурные дубли.
Установить SEO-плагин на технически плохой сайт — примерно как приклеить приборную панель к автомобилю без двигателя. Показатели появились. Инженерия — нет.
И PageSpeed, и SEO-аудит можно использовать как декорацию компетентности
Маркетинговая индустрия любит показатели, которые легко показать клиенту.
Зеленый PageSpeed выглядит убедительно. Красный SEO-аудит выглядит страшно. Сто ошибок в Screaming Frog выглядят профессионально.
Но инструмент не понимает бизнес-контекст так, как его должен понимать специалист.
Не каждое предупреждение является проблемой. Не каждая проблема одинаково важна. Не каждый технический дефект влияет на поисковую видимость одинаково.
Нормальная инженерная работа начинается с приоритетов:
- Что реально мешает crawling;
- Что мешает indexing;
- Что создает дубли;
- Что ухудшает пользовательский опыт;
- Что мешает масштабировать контент;
- Что является архитектурной проблемой;
- Что просто выглядит страшно в автоматическом отчете.
Если подрядчик не способен объяснить проблему человеческим языком и вместо объяснения показывает вам число ошибок в интерфейсе своего сервиса, это плохой признак.
Что действительно должен получить клиент
После разработки клиент не должен получать обещание «теперь вы будете первыми в Google».
Это обещание не контролирует ни разработчик, ни SEO-специалист.
Клиент должен получить более конкретный результат: технически подготовленную платформу для дальнейшего продвижения.
В качественном проекте уже решены базовые инженерные вопросы:
- Сервер корректно отвечает на запросы;
- Страницы имеют управляемые адреса;
- Изменение URL можно обработать редиректом;
- Дубли контролируются;
- Sitemap формируется автоматически;
- Индексацией можно управлять;
- Метаданные доступны через CMS;
- Изображения оптимизируются системой;
- HTML остается понятным и семантическим;
- Структурированные данные реализуются там, где они имеют смысл;
- Сайт не превращен в свалку тяжелых зависимостей;
- Редактор может работать без постоянного вызова разработчика.
SEO-ready означает не «сайт уже продвинут». Это означает «сайт не нужно сначала чинить, прежде чем его можно нормально продвигать».
SEO-специалист после этого не исчезает. Наоборот, наконец начинает заниматься SEO
Сильное техническое основание не отменяет SEO. Оно освобождает SEO от чужой работы.
После запуска специалисту все равно остается огромный пласт задач:
- Исследование спроса;
- Анализ поисковых интентов;
- Изучение конкурентов;
- Разработка структуры новых страниц;
- Подготовка контента;
- Обновление существующих материалов;
- Внутренняя перелинковка;
- Анализ поисковой видимости;
- Работа с Google Search Console;
- Работа с Яндекс Вебмастером;
- Контроль индексации;
- Анализ изменений после обновлений проекта.
За это нормально платить ежемесячно, если объем бизнеса требует постоянной работы.
Но есть принципиальная разница между оплатой развития и оплатой ремонта.
SEO-поддержка должна улучшать сайт относительно вчерашнего дня, а не месяцами приводить его к состоянию, в котором он должен был быть в день запуска.
Техническое SEO тоже требует обслуживания
И здесь не нужно уходить в противоположную крайность. Даже хорошо спроектированный сайт нельзя настроить один раз и объявить технически идеальным навсегда.
Проект развивается. Добавляются новые разделы. Меняется структура. Устанавливается аналитика. Подключается реклама. Появляются интеграции. Обновляется CMS. Переносятся URL. Меняется инфраструктура.
После серьезных изменений технический аудит вполне оправдан.
Разница только в одном: аудит развивающейся системы ищет новые проблемы. Он не должен каждый месяц заново обнаруживать те ошибки, которые существовали еще в день сдачи сайта.
Чек-лист: десять вопросов подрядчику до разработки сайта
Клиенту не нужно становиться backend-разработчиком, чтобы проверить качество проекта. Достаточно задать несколько конкретных вопросов.
- Что возвращает сервер для несуществующей страницы?
- Что произойдет после изменения URL опубликованного материала?
- Как формируется canonical?
- Как формируется Sitemap?
- Что произойдет с Sitemap после публикации новой страницы?
- Можно ли управлять index / noindex через CMS?
- Можно ли изменить title и description без программиста?
- Что происходит с изображением размером 8 мегабайт после загрузки?
- Какие Structured Data используются на сайте и почему?
- Как проект проверяется после deployment?
Если на большинство вопросов исполнитель отвечает «этим потом займется SEO-шник», проблема уже обнаружена.
Инженерное SEO начинается еще до написания страницы
Настоящая техническая подготовка сайта начинается не с аудита после релиза. Она начинается в момент, когда принимаются архитектурные решения.
Как хранятся страницы. Как формируются URL. Что происходит при изменении slug. Какие типы контента существуют. Как формируется canonical. Какие страницы попадают в Sitemap. Как редактор управляет индексацией. Как обрабатываются изображения. Как создаются языковые версии. Как реализуются structured data.
Все это становится кодом задолго до того, как SEO-специалист откроет Search Console.
Сначала построить сайт без учета поисковых систем, а потом продавать клиенту отдельную услугу по превращению этого сайта в технически пригодный для поиска — плохая инженерия, замаскированная под бизнес-процесс.
Итог: хороший сайт не гарантирует позиции. Плохой сайт гарантирует лишнюю работу
В SEO хватает обещаний, которые невозможно проверить заранее: первое место, рост трафика в несколько раз, волшебная микроразметка, секретные факторы ранжирования.
Инженерный подход очень скучный. Зато он измерим.
Сервер либо возвращает правильный код, либо нет. Sitemap либо отражает структуру сайта, либо нет. Метаданные либо доступны редактору, либо для каждого изменения нужен программист. Изображения либо обрабатываются системой, либо пользователь может загрузить на страницу десятимегабайтный оригинал. URL либо контролируются, либо сайт плодит дубли.
Именно поэтому техническое SEO должно начинаться в разработке.
Оно не гарантирует первое место. Оно делает другое: убирает из проекта технические причины, из-за которых деньги на контент, рекламу и продвижение начинают работать хуже, чем могли бы.
Сильный разработчик не продает клиенту идею, что SEO больше не понадобится. Он делает так, чтобы SEO-специалист после запуска занимался продвижением бизнеса, а не ремонтом его сайта.
Источники
В статье намеренно не используются «секретные факторы ранжирования», пересказы агентств и статистика без происхождения. Технические утверждения опираются прежде всего на официальную документацию поисковых систем.
- Google Search Central — Understanding page experience in Google Search results
- Google Search Central — Understanding Core Web Vitals and Google Search results
- Google Search Central — HTTP status codes and network errors
- Google Search Central — Canonicalization and duplicate URLs
- Google Search Central — Build and submit a sitemap
- Google Search Central — Introduction to robots.txt
- Google Search Central — General Structured Data Guidelines
- Yandex Webmaster — Site indexing
- Yandex Webmaster — Using the Sitemap file
- Yandex Webmaster — Using robots.txt
- Yandex Webmaster — How indexing bots and users perceive site pages